PostgreSQL + pgvector,放在同一份資料裡
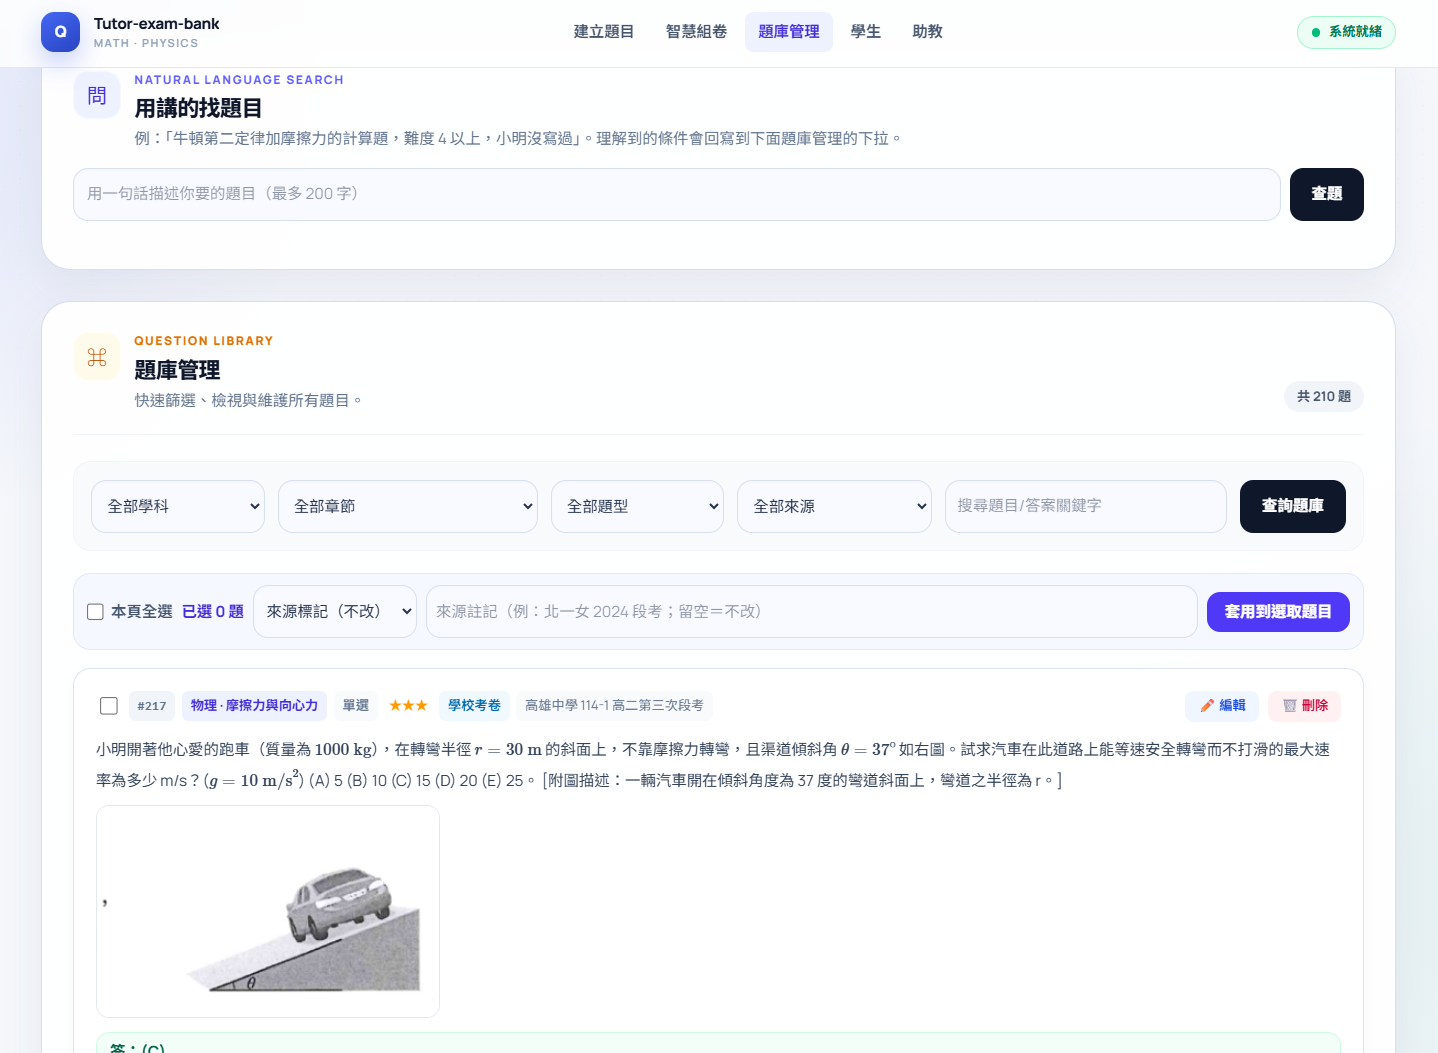
搜尋不只要找相似題,也要排除學生寫過的題、限制難度。這些關聯條件和向量查詢放在同一段 SQL,比另外維護一個向量服務更符合這個單人題庫的規模。
取捨:目前採精確搜尋;資料量明顯成長後,需要重新量測索引與查詢成本。
個人專案 · 教學工具 01 / TL;DR
替數理老師整理 PDF 考卷、避開學生做過的題目,
匯出公式可編輯的 Word 練習卷。
操作影片
從整理題目、查題到組卷與匯出。
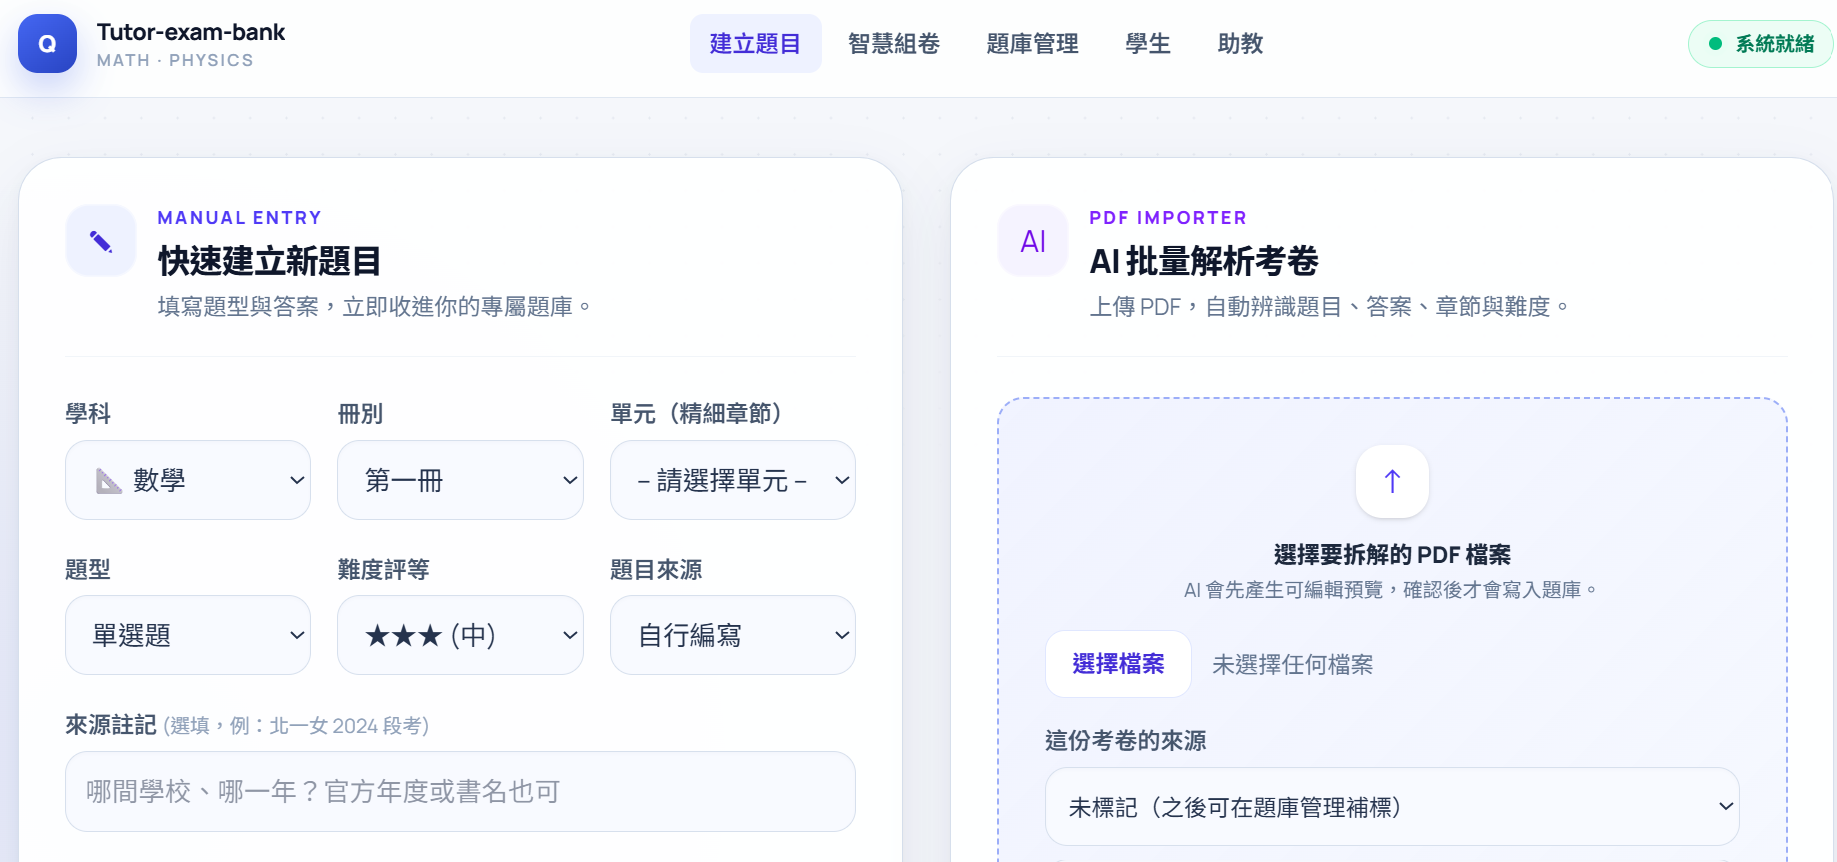
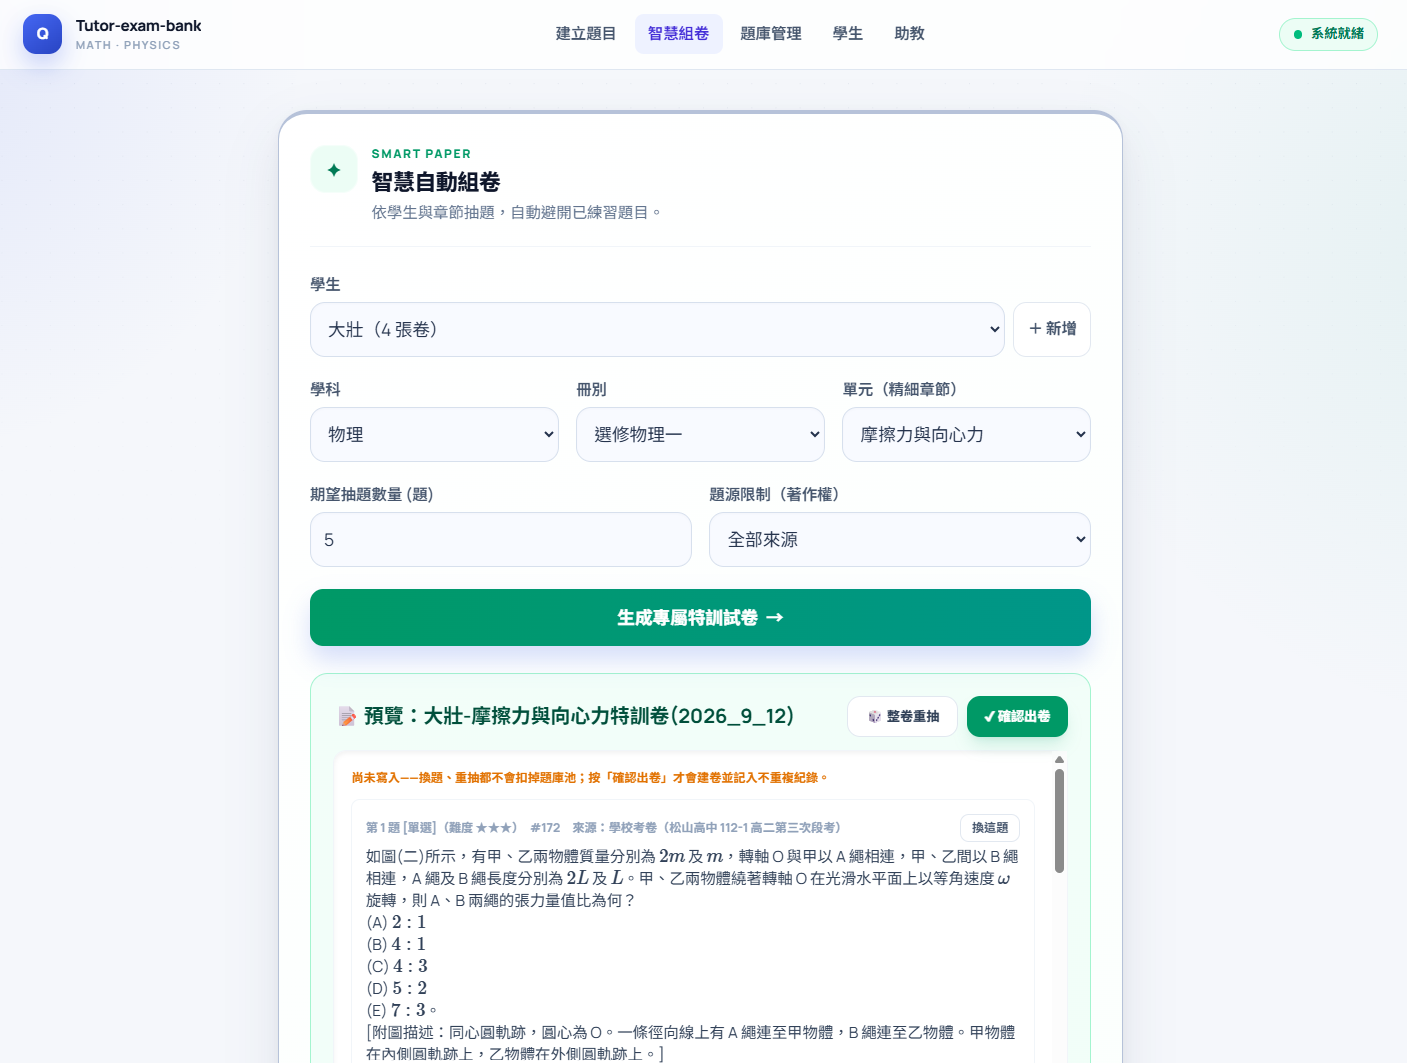
教學時,一份特訓卷要從不同 PDF 翻題目、確認學生有沒有寫過,最後重新整理公式和版面。做這個工具的起點,就是我自己的備課流程。
目標使用者是高中數學、物理老師。比起做一個問答介面,我更在意最後能不能拿到一份適合這位學生、還能修改的 Word 考卷。
沿著箭頭閱讀;藍色是通過流程,橘色是需要人工處理的分支。小螢幕可左右滑動或開啟大圖。
開啟架構大圖 ↗
搜尋不只要找相似題,也要排除學生寫過的題、限制難度。這些關聯條件和向量查詢放在同一段 SQL,比另外維護一個向量服務更符合這個單人題庫的規模。
取捨:目前採精確搜尋;資料量明顯成長後,需要重新量測索引與查詢成本。
拆題、分類、驗答的順序已知。我用資料庫狀態機保存進度、分配工作和限制重試,模型只負責各步驟的內容。沒有為這條固定流程再引入 Agent 框架或 Redis 佇列。
取捨:狀態、租約與錯誤處理要自行維護;新增節點也要同步修改契約與測試。
輸入是一題題中英數混排內容,還要插入題號、答案、換頁與圖片。我用自製解析器接上 docx 的數學物件,沒有把整份文件轉換交給 Pandoc。
取捨:只支援目前教學需要的 LaTeX 語法子集,覆蓋範圍不如通用文件轉換工具。
向量搜尋能找到敘述不同、概念相近的題目;全文搜尋補上專有名詞與符號。兩路分數不能直接相加,所以用 RRF 按名次融合。API 與評估程式共用同一份查詢,避免測到的路徑和實際使用不同。
原本:文字比對以 LIKE 找相同文字,換個說法就可能漏掉。
現在:混合檢索先套用學生與章節條件,再合併概念相似度與關鍵詞名次。
-- 把同一題的兩路名次合併;缺席的一路計為 0。
SELECT id,
  -- 名次越前,分數越高;60 是 RRF 的平滑常數。
  (COALESCE(1.0 / (60 + vec.r), 0)
   + COALESCE(1.0 / (60 + kw.r), 0))::float8 AS score,
  vec.r::int AS vec_rank,
  kw.r::int AS kw_rank
-- 保留只在向量或只在全文搜尋出現的題目。
FROM vec FULL OUTER JOIN kw USING (id)
每一路用 1 / (60 + 名次) 計分;某一路沒有命中就算 0。合併前先用相同的候選集合套用學生與章節條件,再依融合分數排序。
早期:正則式轉換處理特定公式形式,遇到巢狀結構不易擴充。
現在:遞迴解析將公式拆成物件樹,分子、分母和內層公式各自保留結構。
\frac{a}{b}MathFraction先把文字切成 token,再以遞迴解析指令和參數。遇到分數指令時,分子、分母各自解析成物件,因此可以處理巢狀結構,最後交給 docx 產生 Word 原生公式。
// 三種分數指令,都建立相同的 Word 分數物件。
if (name === 'frac' || name === 'dfrac' || name === 'tfrac') {
    // 依序解析分子、分母,參數內還可以包含其他公式。
    const num = parseArg();
    const den = parseArg();
    // 保留結構,匯出後仍可在 Word 中修改。
    return new MathFraction({ numerator: num, denominator: den });
}
關鍵是保留分子與分母的結構,讓使用者匯出後還能改題。一般敘述則保留為文字,不必把整題做成圖片。
sort(() => 0.5 - Math.random()) 洗牌。會回傳題目,卻不代表每種排列有相同機會出現。Recall@5(前 5 筆召回率)=「前 5 筆中命中的相關題數」÷「人工標記的相關題總數」,再對有效查詢取平均。它看的是有沒有漏掉相關題,不是前 5 筆有幾筆正確,也不是答案正確率。
例子(僅供理解):人工標記有 4 題相關,搜尋前 5 筆找到其中 3 題,這次的召回率就是 3 ÷ 4=75%。
混合搜尋比 LIKE 多 12.5 個百分點。未召回比例從 12.5% 降到 0%;相對純向量則多 3 個百分點。這是各查詢比例的平均,不是把 40 筆直接換算成漏題數。
混合搜尋比純向量低 0.1335。找得比較齊,不一定把第一個相關題排得更前面。MRR 不是準確率,也不能直接倒算平均名次。
以上為專案既有 40 筆人工評估資料的記錄,本次未重跑檢索評估;結果不代表所有章節或未見過的查詢。
漏召回較少,表示前幾筆候選比較不容易遺漏可用題目,可能減少換關鍵字、反覆搜尋的需要。但這次沒有量測實際節省多少操作或時間。
混合搜尋的第一個相關結果可能較後面,老師需要多看幾筆。如果未來改成自動採用第一筆結果,就應優先改善排序,不能只看召回率。
目前的選擇:老師會從候選清單挑題,因此先採用較高召回率的混合搜尋;未來若需要自動取第一筆,會用排序指標重新驗證這項選擇。
備課的變化。「約兩小時到數分鐘」是我使用時的經驗估計,目前沒有正式計時紀錄,因此不當作效能基準。比較確定的是題目、學生紀錄和 Word 匯出可以串起來,整理過的題目下次能繼續用。
洗牌模組的 11 項測試全部通過,包含 10,000 次抽樣、固定種子與舊演算法對照。這是抽樣分佈的檢查,不是整套系統的正確率。
node --test exam_pro/test/unit/shuffle.test.js我會更早把「資料能不能入庫」和「模型有沒有回應」分開檢查,也先建立一小組人工確認的題目與查詢,再逐步調整模型和檢索方式。這次最有用的經驗,是把錯誤留下來,讓每次修改都有可以比較的對象。
後續會先從教學使用與驗證品質著手,再評估功能擴充。以下是規劃方向,尚未承諾完成時間;其中參數化模板是原有文件保留的項目,其餘是依目前限制整理的改善提案。
補入更多不同章節、難度與表達方式的人工標記查詢,包含「用概念描述」和「用公式或專有名詞查詢」兩種情境。保留獨立測試資料,避免調整時只對既有 40 筆變好。
怎麼判斷有效:同時追蹤各類查詢的 Recall@5、MRR 與查詢時間;確認改善不是只集中在少數章節。
先分析混合搜尋把正確題目往後移的案例,比較融合方式與候選數量。若仍有明確需求,再測試重排模型,並記錄新增的等待時間與費用。
怎麼判斷有效:提升第一個相關結果的排序,同時維持召回率;不要用明顯變慢的操作換取小幅分數提升。
把適合變化數值的題型定義為模板,限制參數範圍,並連同答案、單位與必要條件一起驗證。優先從少數可確定驗算的題型開始,避免只替換數字卻產生無解或不合理的題目。
怎麼判斷有效:產生的題目能重新驗算、追溯來源模板,並由老師確認後才納入正式題庫。
統整常見的公式、分類和驗答失敗,讓老師在複核時看得到原因與待確認的位置。把教學中遇到的巢狀公式、矩陣及中英混排整理成匯出範例,持續檢查 Word 是否可編輯、可列印。
怎麼判斷有效:追蹤複核耗時、重複修正次數與匯出格式問題,讓改善有實際使用紀錄可比較。